Perché una pagina possa comparire su Google, il motore di ricerca deve prima scoprirla, riuscire a scansionarla e decidere di inserirla nel proprio indice. Sono passaggi diversi, spesso confusi tra loro, e una parte importante della SEO tecnica consiste proprio nel verificare che avvengano correttamente.
Crawling, indicizzazione e sitemap XML fanno parte di questo processo. Capire come sono collegati aiuta anche a interpretare meglio problemi frequenti: pagine che Google non trova, URL scansionati ma non indicizzati, contenuti esclusi dall’indice o sitemap che sembrano non produrre gli effetti attesi.
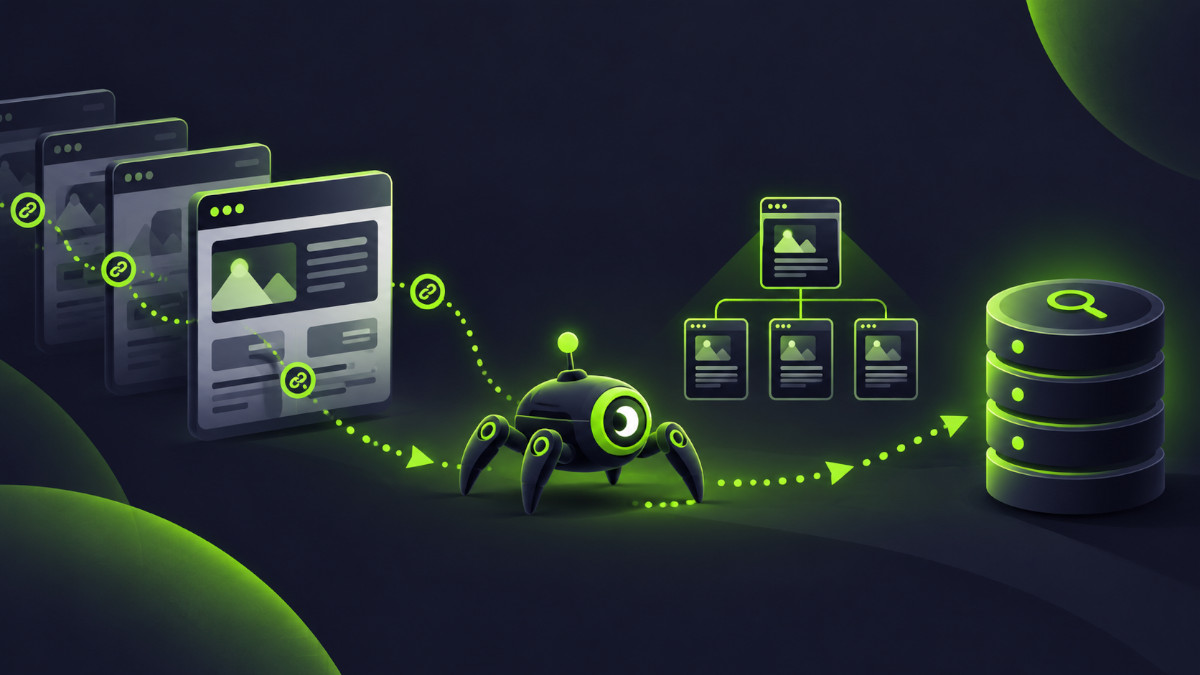
Crawling, indicizzazione e posizionamento non sono la stessa cosa
Quando si parla di indicizzazione di un sito web, è utile distinguere almeno tre fasi.
| Fase | Cosa succede |
|---|---|
| Crawling | Googlebot e gli altri crawler visitano le URL e ne analizzano le risorse accessibili. |
| Indicizzazione | Google elabora le informazioni raccolte e decide se inserire una pagina nel proprio indice. |
| Posizionamento | Una pagina indicizzata può essere mostrata nei risultati di ricerca in relazione a una specifica query. |
Essere scansionati, quindi, non significa essere automaticamente indicizzati. Allo stesso modo, una pagina presente nell’indice non ha la garanzia di comparire nelle prime posizioni.
Questa distinzione è importante perché permette di affrontare il problema giusto. Se Google non riesce a raggiungere una pagina, intervenire sul testo o sul title difficilmente risolverà il problema principale. Se invece la pagina è correttamente indicizzata ma non intercetta le ricerche desiderate, l’analisi dovrà spostarsi su intento di ricerca, contenuti, struttura, autorevolezza e altri fattori SEO.
Come Google scopre e scansiona le pagine di un sito
Il crawling è il processo con cui un motore di ricerca esplora il web. Google utilizza crawler come Googlebot per visitare URL, seguire collegamenti e recuperare le informazioni necessarie a comprendere le pagine.
Un sito non deve però affidarsi al caso per rendere reperibili i propri contenuti.
I link interni hanno un ruolo centrale. Una pagina collegata dalla navigazione o da altri contenuti pertinenti è più facile da raggiungere rispetto a una URL isolata, priva di collegamenti interni. Una struttura del sito chiara aiuta quindi sia le persone sia i crawler a comprendere le relazioni tra le diverse pagine.
Anche la sitemap XML può facilitare la scoperta delle URL, soprattutto quando il sito contiene molti contenuti, viene aggiornato frequentemente o presenta pagine difficili da raggiungere attraverso la normale navigazione.
La possibilità di scansionare una risorsa dipende inoltre dalle indicazioni presenti nel file robots.txt, dalle risposte del server e dalla corretta accessibilità delle risorse necessarie al rendering della pagina.
La SEO tecnica non consiste quindi nel “far entrare Google” nel sito con un singolo comando. Si tratta piuttosto di costruire un ambiente in cui le pagine importanti siano raggiungibili, riconoscibili e tecnicamente coerenti.
Perché una pagina può essere scansionata ma non indicizzata
Uno dei dubbi più comuni nasce quando Google conosce una URL e l’ha anche visitata, ma la pagina continua a non comparire nell’indice.
Non è necessariamente un’anomalia.
Google può decidere di non indicizzare una pagina oppure di considerare un’altra URL come versione principale dello stesso contenuto. Può inoltre incontrare direttive tecniche che impediscono l’indicizzazione.
Tra gli elementi da controllare ci sono la presenza di un noindex, l’URL canonical dichiarata, eventuali duplicazioni, redirect, errori del server e la disponibilità effettiva del contenuto durante il rendering.
Un caso tipico riguarda le pagine molto simili tra loro. Se più URL presentano contenuti sostanzialmente equivalenti, Google può cercare di individuare una versione canonica da utilizzare come riferimento. Il tag rel="canonical" aiuta a comunicare quale URL si preferisce, ma deve essere coerente con gli altri segnali presenti nel sito.
Anche la qualità e l’utilità della pagina entrano nel processo. Rendere una URL tecnicamente accessibile non obbliga un motore di ricerca a conservarla nel proprio indice.
Per questo motivo indicizzare un sito non significa semplicemente inviare tutte le sue URL a Google. L’obiettivo dovrebbe essere rendere facilmente accessibili e comprensibili soprattutto le pagine che hanno effettivo valore per utenti e motori di ricerca.
Sitemap XML: cosa fa davvero
La sitemap XML è un file attraverso cui è possibile indicare ai motori di ricerca le URL che si considerano rilevanti all’interno del sito.
È utile pensarla come una mappa per la scoperta dei contenuti, non come una richiesta obbligatoria di indicizzazione.
Inserire una pagina nella sitemap non garantisce infatti che venga scansionata immediatamente e, soprattutto, non garantisce che venga indicizzata.
Una sitemap ben gestita dovrebbe essere coerente con la reale struttura del sito. In genere è opportuno includere le URL che si desidera rendere disponibili nei risultati di ricerca e che rappresentano le versioni canoniche dei contenuti.
Se una pagina viene dichiarata importante nella sitemap ma contemporaneamente presenta segnali tecnici contrari, l’insieme diventa poco coerente. È il caso, per esempio, di una URL presente nella sitemap ma impostata come noindex, oppure di una pagina che dichiara come canonica una URL differente.
Anche da questo punto di vista la sitemap non dovrebbe essere considerata uno strumento isolato: funziona all’interno di una più ampia architettura fatta di navigazione, link interni e indicazioni tecniche coerenti.
Robots.txt e indicizzazione: un equivoco frequente
Il file robots.txt serve principalmente a gestire l’accesso dei crawler a determinate aree o risorse del sito. Bloccare una URL tramite robots.txt non equivale però a chiedere che venga esclusa dall’indice.
Google può venire a conoscenza dell’esistenza di una URL anche attraverso link presenti su altre pagine. In alcuni casi una URL non scansionabile potrebbe quindi essere conosciuta e comparire nell’indice senza che Google abbia potuto leggerne normalmente il contenuto.
Esiste inoltre un’altra conseguenza importante: se Googlebot non può accedere alla pagina, potrebbe non riuscire nemmeno a leggere un eventuale meta tag noindex presente al suo interno.
robots.txt e noindex rispondono quindi a esigenze diverse. Il primo interviene principalmente sul crawling, il secondo comunica che una pagina non dovrebbe essere indicizzata.
Confonderli può generare configurazioni contraddittorie e rendere più difficile capire perché una determinata URL continui a comparire, o non compaia, nei risultati di ricerca.
Come verificare l’indicizzazione del sito web
Google Search Console è uno degli strumenti principali per controllare come Google interpreta le URL di un sito.
Il Controllo URL consente di analizzare una pagina specifica e verificare, tra le altre informazioni disponibili, se Google la conosce, se è stata indicizzata e quale URL considera canonica.
I report dedicati all’indicizzazione aiutano invece a osservare il fenomeno a livello più ampio. Possono mettere in evidenza URL escluse, errori e motivazioni che richiedono un approfondimento.
Anche il rapporto sulle sitemap permette di controllare se i file inviati sono stati elaborati correttamente.
Per siti complessi può essere utile aggiungere ulteriori livelli di analisi, come i log del server. I log consentono di osservare direttamente le richieste ricevute dal sito e possono quindi aiutare a capire quali aree vengono effettivamente visitate dai crawler e con quale frequenza.
Quando una pagina importante non risulta indicizzata, un controllo sensato segue una sequenza logica:
- verificare che la URL sia raggiungibile attraverso link interni e restituisca una risposta HTTP corretta;
- controllare che crawling e indicizzazione non siano bloccati involontariamente;
- verificare
noindex, canonical, redirect e possibili duplicazioni; controllare la presenza della URL nella sitemap quando pertinente; - utilizzare infine Search Console per confrontare le indicazioni tecniche del sito con ciò che Google ha effettivamente rilevato.
Procedere in quest’ordine evita di concentrarsi su singoli dettagli prima di aver escluso problemi più basilari.
Crawl budget: quando è davvero un problema
Il crawl budget descrive, in termini generali, le risorse che Google dedica alla scansione di un sito.
È un argomento importante nella SEO tecnica, ma non tutti i siti hanno la necessità di ottimizzarlo in modo specifico.
Su portali molto grandi, e-commerce con numerose combinazioni di URL o siti che producono e modificano continuamente grandi quantità di pagine, evitare che i crawler sprechino risorse su URL inutili può diventare rilevante.
Per siti piccoli e medi, invece, è spesso più utile concentrarsi prima su problemi molto più concreti: pagine importanti difficili da raggiungere, link interni assenti, errori del server, duplicazioni, redirect non necessari o sitemap poco coerenti.
Ottimizzare il crawling non significa cercare di far visitare a Google ogni URL con la massima frequenza possibile. Significa soprattutto fare in modo che le risorse del sito aiutino i crawler a individuare e comprendere i contenuti che contano davvero.
La SEO tecnica parte dalla possibilità di trovare e comprendere le pagine
Contenuti utili, keyword e ottimizzazione on-page possono produrre risultati solo se le pagine sono tecnicamente accessibili e possono entrare nel processo di ricerca.
Per questo crawling, indicizzazione e sitemap non sono aspetti separati dalla strategia SEO. Sono le fondamenta che permettono ai contenuti di essere scoperti, interpretati e, quando Google li ritiene idonei, inseriti nell’indice.
Quando qualcosa non funziona, il punto non è quindi chiedersi soltanto “perché questa pagina non si posiziona?”, ma capire prima in quale fase del processo si trova il problema.
Hai dubbi sull’indicizzazione o sulla struttura tecnica del tuo sito?
Se alcune pagine importanti non vengono scoperte o indicizzate correttamente, un’analisi tecnica può aiutare a capire dove si interrompe il processo e quali interventi hanno realmente priorità.
Puoi approfondire come lavoro nella pagina dedicata alla consulenza SEO e contattarmi per valutare il tuo progetto.
